
網站上線了,網域也接好了:功能能用、有網址、可以分享。
但要讓別人把資料放進來,我得先回答兩件事:資料掉了救不救得回來,系統哪裡壞了我會不會知道。
託管平台的入門方案通常沒有內建備份。所以自己做:一個小容器,裡面是 pg_dump 加上傳到物件儲存的工具,每天跑一次。
pg_dump "$DATABASE_URL" --format=custom --compress=6 --no-owner --no-privileges --file "/tmp/${FILE}"
aws s3 cp "/tmp/${FILE}" "s3://${BUCKET_NAME}/${PREFIX}/${FILE}" --endpoint-url "$AWS_ENDPOINT_URL" --only-show-errors
出處:ops/backup/backup.sh:16-19(節錄)
用 --format=custom 而不是純 SQL,因為它壓縮過,而且還原時可以選擇性地還原部分物件。舊檔依檔名裡的時間戳刪掉,預設留三十天。
做到這裡,只知道 dump 檔產生了,不知道它還原得回來。
dump 檔可能是零位元組,也可能上傳到一半被截斷。這些都要等到真的需要還原那天才會發現。
所以有第二支腳本,每週跑一次。每一個步驟都是一個會讓整支腳本結束的檢查:
AGE_H=$(( ( $(date -u +%s) - DUMP_TS ) / 3600 ))
[ "$AGE_H" -le 36 ] || { echo "[verify] newest dump is older than 36 h: the daily backup is not running"; exit 3; }

SIZE="$(wc -c < /tmp/latest.dump)"
[ "$SIZE" -gt 10240 ] || { echo "[verify] dump suspiciously small"; exit 4; }
pg_restore --list /tmp/latest.dump > /tmp/toc.txt
grep -q 'TABLE DATA public notes' /tmp/toc.txt || { echo "[verify] archive has no notes table data"; exit 5; }

psql "$ADMIN_URL" -v ON_ERROR_STOP=1 -q -c "DROP DATABASE IF EXISTS ${SCRATCH_DB};" -c "CREATE DATABASE ${SCRATCH_DB};"
trap 'psql "$ADMIN_URL" -q -c "DROP DATABASE IF EXISTS ${SCRATCH_DB};" || true' EXIT
pg_restore --no-owner --no-privileges --exit-on-error --dbname "$SCRATCH_URL" /tmp/latest.dump
NOTES="$(psql "$SCRATCH_URL" -tA -c 'SELECT count(*) FROM notes')"
[ "$NOTES" -ge "$MIN_NOTES" ] || { echo "[verify] fewer notes than MIN_NOTES=${MIN_NOTES}"; exit 6; }
出處:ops/backup/verify.sh:17-38(節錄;省略下載 dump 與組連線字串)
自訂離開碼從 2 到 6:沒有 dump、太舊、太小、沒有 notes 表、筆數不夠。三十六小時那一條抓的是備份根本沒在跑:每日排程停了,不會有任何一步報錯,最新的檔案只會一天一天變舊。trap … EXIT 那行保證暫存資料庫一定被清掉,就算中間哪一步爆掉也一樣。
任何一步失敗,整個排程任務就是失敗,在平台的執行紀錄上會標紅。
這支腳本跑在 postgres:18-alpine 映像裡,裡面的 date 是 BusyBox 版,所以判斷 dump 新舊那行得寫成這樣:
# busybox date (alpine) parses with -D; GNU date needs "YYYYMMDD HH:MM:SS"
DUMP_TS="$(date -u -D '%Y%m%dT%H%M%SZ' -d "$STAMP" +%s 2>/dev/null || date -u -d "$(echo "$STAMP" | sed -E 's/([0-9]{8})T([0-9]{2})([0-9]{2})([0-9]{2})Z/\1 \2:\3:\4/')" +%s)"
出處:ops/backup/verify.sh:15-16、ops/backup/Dockerfile:3
date -d 在我的機器上正常,在容器裡直接報錯:我的機器上是 GNU 版,吃的參數不一樣。所以腳本要丟進目標映像裡跑過一次才算數,讀文件看不出這種差別。
第一次演練成功的那天我記下了還原出來的筆數:使用者兩筆、工作區兩筆、筆記三十一筆。那是 dump 檔第一次真的被還原出來。
外部監控服務會定時打你的網站,掛了就通知你。但「HTTP 200」只能告訴你網頁伺服器活著,不能告訴你備份三天沒跑、或者付款的 webhook 一直驗簽失敗。
我的做法是讓 /healthz 多回一個陣列:
{
  "ok": true,
  "service": "wikibrain",
  "version": "0.2.0",
  "commit": "acf4598",
  "encryption": "v2",
  "degraded": ["backup_stale"],
  "status": "degraded"
}
這是示意:欄位與實際 /healthz 回應相同,degraded 有內容時 status 才會是 "degraded"。
degraded 裡會出現:備份超過三十六小時、webhook 簽章連續失敗、某個服務十四天內要續約、某項資源用量到達危險水位。
組出這個回應的程式只有兩句:
const d = await (ops()?.degraded() ?? Promise.resolve([])).catch(() => ['db']);
res.json({ ok: true, service: 'wikibrain', version: config.version, commit: config.commit,
           encryption: encryptionVersion(), degraded: d, status: d.length ? 'degraded' : 'healthy' });
.catch(() => ['db']) 那段是刻意的:連檢查本身都失敗時,不要讓整個端點掛掉變成 500,而是回報「資料庫這項異常」。
然後在 UptimeRobot 上設一支監控,五分鐘打一次 /healthz,關鍵字比對 "status":"healthy"。免費方案五十支監控、只寄信到帳號信箱,剛好夠用。任何一項內部指標異常,都會變成一則通知,而不需要另外接一套監控系統。
成本只有多回幾個欄位:端點本來就有,監控服務用免費方案。
再往上一層,是一個只有管理者看得到的頁面,看的是使用者、成本與上限。伺服器活不活著交給 /healthz。
這些資料原本散在五個服務的後台,要看就得一個一個登入。收在一頁,是為了打開一次就看完。
這個面板的服務清單一開始是我寫死在程式碼裡的,包含各服務的帳號信箱與價格。後來要開源的時候才發現這是個問題,那是營運資料,不該編進原始碼。現在它存在資料庫裡,程式裡只有一份不含帳號的空範本。
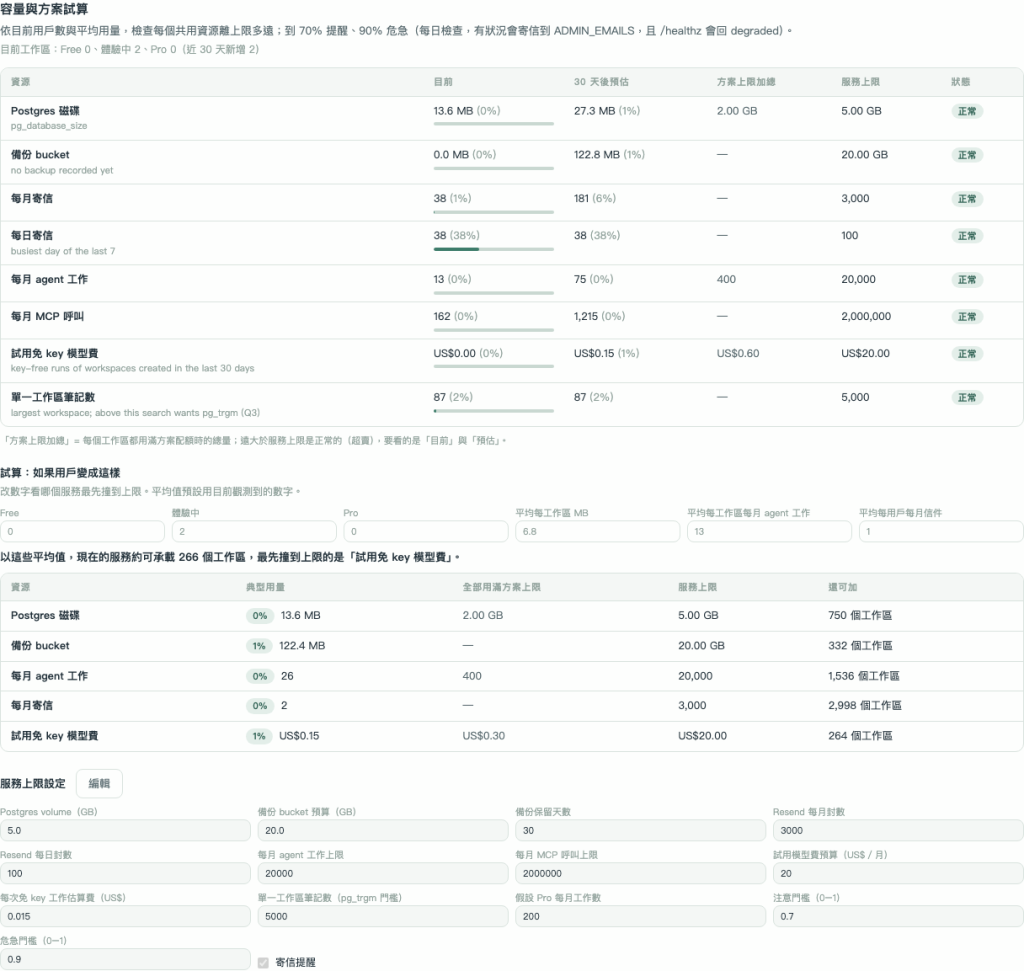
依帳號等級試算「還能收多少人」,以及最先會碰到哪一項。
這一篇把上線之後要盯的兩件事做成會自己失敗的排程。備份每天 dump、每週還原進暫存庫並數筆數,任何一步失敗就在平台的執行紀錄上標紅;內部指標放進 /healthz,監控服務比對 "status":"healthy",異常變成一封信。兩件事都不靠我記得去打開那些後台。


 iThome鐵人賽
 看影片追技術